

インドは、3 つの別々の軸に沿って人工知能の知的財産とデータのプライバシーを規制しています。 デジタル個人データ保護法 2023 は、トレーニング セットと出力で個人データを管理し、著作権法 1957 はモデルに入力された保護表現を制御し、特許法 1970 はモデル自体の特許性を制御します。 3 つの体制は互いに崩壊しません。
この記事は、2026 年 4 月時点でのインドの立場を定めており、EU AI 法、GDPR、英国著作権法第 9 条 (3)、1988 年デザインおよび特許法、および AI トレーニング データに関する米国の訴訟が保留されていることに関連しています。 のより広いフレームの場合 人工知能の知的財産法、この記事では、データ プライバシーとの特定のやり取りにズームインします。 これは、AI ビジネスに助言する実践者や、インドで AI 製品を構築する創業者向けに書かれています。
| 簡単な答え: 三角形の練習 |
| • 3 つのインド法規がすべての AI 製品に触れています: DPDPA 2023 (トレーニングまたはアウトプットにおける個人データ)、著作権法 1957 (トレーニング データにおける保護表現)、1970 年特許法 (モデル自体の特許性)。 • どちらかを遵守しても、他人を吸収しません。 データセットは DPDPA に準拠している可能性がありますが、それでも著作権を侵害します。 • ジェネレーティブ AI と著作権に関する DPiIT ワーキング ペーパー、パート I (2025 年 12 月 8 日) は、AI トレーニングに必須の集合ライセンス モデルを提案しています。 協議は 2026 年 2 月 6 日に閉鎖されました。これは、運用法ではありません。 • DPDP フレームワークは、2025 年 11 月 13 日に個別の官報通知を通じて通知されました。 規則 4 (同意マネージャーの登録) は、公開から 1 年間開始されます。 法律の規則 3、5 ~ 16、22、23 および第 3 節から第 17 条は、公開から 18 か月の効力を有する。 |
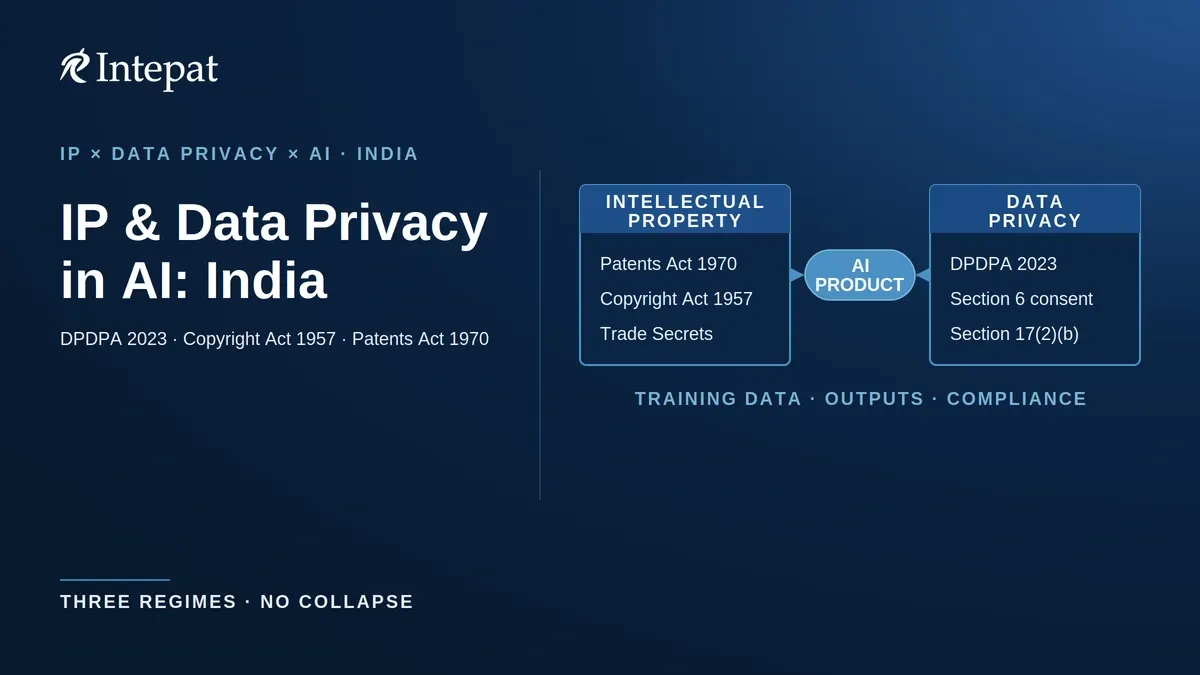
AI 製品スタック全体での IP とデータのプライバシーのマッピング
インドの AI 製品は、スタックの異なる層で各体制に影響を与えます。 モデル アーキテクチャと新しいトレーニング テクニックは、セクション 3(k) に従って、特許法の下に置かれます。「数学的またはビジネスの方法またはコンピューター プログラム自体またはアルゴリズム」に関するバー。 特定のトレーニング方法またはアーキテクチャの特許性により、技術効果および技術貢献テストが有効になります。 Ferid Allani v Union of India (デリー HC、2019 年 12 月 12 日) および Raytheon Company v コントローラーの特許とデザインの総括 (Delhi HC、2023 年 9 月 15 日)、現在は CRI ガイドライン 2025 (公式PDF. それらのガイドラインの下で、 AI と機械学習の特許 AI 支援の発明に分割すると、セクション 3(k) が具体的なアプリケーションで技術的な効果を示し、自律的に生成された AI によって生成された発明が解明される可能性があります。 現在のインドの特許法は、AI システムを発明者として認めていません。セクション 6 は、真の発明者であると主張する「人」を想定しています。
トレーニング データセットとそこから生成された出力は、著作権法第 1957 条に基づきます。セクション 14 は、著作権所有者に、「電子的手段による任意の媒体への保管」を含む独占的複製権を付与します。 2026 年 4 月現在、インドの著作権法には明示的なテキストおよびデータマイニングの免除は存在しません。 Generative AI と Copyright に関する DPiit ワーキング ペーパー、パート I は、このギャップを認め、第 52 条の司法拡張ではなく、立法上の対応を提案しています。
同じデータセットまたは出力を流れる個人データは、DPDPA 2023 の下にあります。個人データを処理する目的と手段を決定する企業は、セクション 2(i) に基づくデータ受託者です。 データが関係する個人は、セクション 2(j) に基づくデータ プリンシパルです。 この法律は、インド国内のデータ プリンシパルへの商品またはサービスの提供に関連する場合、第 3 条 (a) に基づくインド国内および第 3 条 (b) に基づく準州外に適用されます。 したがって、インドのユーザーにサービスを提供する海外に拠点を置く AI 企業は、法律の範囲内にあります。
トレーニング データ: 著作権法と DPDPA が衝突する場所
トレーニング コーパスは、3 つのレジームすべてがアタッチできる単一ポイントです。 モデル トレーニングのための著作権で保護された作品のスクレイプ、ダウンロード、または保管は、セクション 14(a)(i) の複製権に関与し、「電子的手段による任意の媒体への保管」を明示的にカバーしています。 この文言は、AI トレーニング中の中間コピーが実際の侵害の問題になるのに十分に広範囲ですが、インドではモデル トレーニングへのセクション 14 およびセクション 52 の適用は未解決のままです。
の重要な中間問題の 1 つ アジア ニュース インターナショナル v オープンアイ、CS(COMM) 1028/2024 は、中間コピーがセクション 52(1)(b) の「一時的または偶発的な保管」のカーブアウトに該当するかどうかです。 デリー高等裁判所は、2026 年 3 月 27 日の 32 回の公聴会の後、ANI の暫定申請を留保しました。 問題は未解決のままです。 関連するドクトリンの議論は、Intepat のケースに留まります。 ani v openai そしてより広い AI とビッグデータの著作権分析。
著作権からデータ プライバシーまで、個人データ層は同じコーパスを異なる条件で交差させます。 DPDPA セクション 4 に基づき、個人データの処理には、セクション 6 に基づく同意またはセクション 7 に基づく正当な使用が必要です。
セクション 17(2)(b) の調査免除は、「個人データは、データ プリンシパルに固有の決定を行うために使用されるべきではない」場合にのみ利用でき、処理は「規定の基準に従って実行されます」。 セクション 17(2)(b) に依存することは、モデルが特定可能な個人に関連するアウトプット、推論、プロファイリング、ランキング、またはターゲティングを生成する場合はどこでも困難です。 それが「データ プリンシパルに固有の決定」に相当するかどうかは、司法的に未解決のままです。
セクション 3(c)(ii) は、開業医が時々想定するよりも、より狭い脱出を作成します。 この法律は、データ プリンシパルによって、または法定を公開する義務の下にある人物によって公開された個人データには適用されません。 自費出版のブログ投稿、ユーザーが意図的に公開したソーシャル メディアの投稿、法定政府の登録簿は DPDPA の範囲外です。 データ プリンシパルが自身が公開しなかったソースからスクレーパーによって抽出された個人データは公開されていません。 したがって、公開されている個人データの一部は、著作権法第 14 条に基づいて著作権制限を引き付けながら、セクション 3(c)(ii) を通じて DPDPA の範囲外になる可能性があります。
2025 年 12 月 生成 AI と著作権に関する DPiit ワーキング ペーパー は、「One Nation One License One Payment」と呼ばれる必須の集団ライセンス モデルを提案しています。このモデルでは、商用 AI 開発者は、トレーニング アクセスを許可されたトレーニング アクセスと引き換えに、グローバルな収益に合わせて調整された中央の非営利著作権協会にロイヤルティを支払います。 公開協議は 2026 年 2 月 6 日に閉鎖されました。ワーキング ペーパーは、協議中の政策の方向性を反映しています。 これは法案でも行政規則でもなく、AI トレーニングに関するインドの著作権法の地位は、現在、著作権法に定められているものです。
モデルの出力、作成者、個人データの推論
インドの著作権法は、すでにコンピューターで生成された作品を検討しています。 1957 年著作権法第 2 条 (d)(vi) は、「コンピュータで生成された」文学的、劇的、音楽的、または芸術的な作品の作者を、「作品を創造する人」と定義しています。 この規定は、生成 AI よりも前のことであり、プロンプト エンジニアやモデル オペレーターなど、人間の原因を人間の原因に割り当てるためのテキスト フックとして機能します。 現代の生成 AI システムにどのように適用されるかは、インドの高等裁判所ではほとんどテストされていません。
インドの立場は、1988 年の著作権、意匠、特許法第 9 条 (3) の英国のアプローチの間に位置し、著作権者を「作品の作成に必要な手配」を行う人物に著作権を割り当て、 Thaler v PerlmutterDC 巡回裁判所が 2025 年 3 月に AI のみの作品は著作権で保護されていないと断言したが、最高裁判所の判決は 2026 年 3 月 2 日に裁量を拒否したとき、無傷のままであった (No. 25-449)。 セクション 2(d)(vi) の実際的な拡張は、次の問題で表面化します。 オーサーシップと所有権を迅速に確認します コラボレーティブな人間と AI の作成。
個人データを明らかにする出力は、露出の 2 番目の層を引き付けます。 識別可能な個人の画像、指名された人物に関する推論、または認識可能なパフォーマーに似た音声を生成するモデルは、DPDPA のセクション 2(t) の意味で個人データを処理します。 有名人については、インドの裁判所は、そのようなアウトプットを、コモンローの宣伝権の下で実行可能なものとして扱ってきました。
に Titan Industries v Ramkumar Jewelers (Delhi HC 2012)、裁判所は、ジュエリーの広告での類似の使用から、アミターブとジャヤ バッチャンを保護しました。 12 年後、イン Arijit Singh v Codible Ventures LLP (ボンベイ HC、2024 年 7 月 26 日、2024 年 SCC オンライン BOM 2445)、R. 歌手の「名前、声、声のスタイル、ボーカルのテクニック、ボーカルのアレンジと解釈、マニエリスム、シグネチャー」。 裁判所は、有名人を対象とした無許可の生成 AI コンテンツは「良心に衝撃を与える」と述べました。 スレッドは の intepat 説明を介して実行されます インドの人格権。
有名人以外の場合、宣伝権はあまり発達していません。 主な車両は DPDPA セクション 12 であり、データ プリンシパルに同意に応じて処理された個人データの修正、完了、更新、および消去権を付与します。 画像、音声、または識別属性が同意なしにモデル出力に表示されるユーザーは、消去を要求することがあります。 法律で定着が義務付けられていない限り、データ受託者は消去する必要があります。
DPDPA の下での企業秘密、チャットGPT プロンプト、およびツイン違反
インドには専用の企業秘密法がありません. インドの企業秘密保護 重複する 3 つのメカニズムに基づいています: 信頼違反、契約上の NDA および雇用制限条項、および 2000 年情報技術法第 72 条。 個別の同意を必要としない正当な使用として、「企業のスパイ活動の防止、企業秘密の守秘義務、知的財産、機密情報の維持」のため。
2023 年 4 月の Samsung 事件は、AI ジェネレーティブ AI プロンプトがどのようにして双子の露出を生み出すかを示しています。 Samsung の従業員 3 人が独自のソース コード、社内の会議メモ、およびハードウェア テスト パターンを chatgpt に貼り付け、その後、社内ネットワークでのジェネレーティブ AI ツールを禁止しました。
実質的な DPDPA 義務が有効になると、インドのデータ受託者内の同一のイベントが 2 つのトラックで責任を引き起こす可能性があります。 IP トラックでは、機密性が著しく損なわれる可能性があり、貿易秘密または自信違反の主張の執行が大幅に難しくなる可能性があります。 基礎となる発明の特許性は、開示された内容と、開示が可能になり、公開されたかどうかに応じて、絶対的な新規性の基準の下で危険にさらされます。 DPDPA トラックでは、貼り付けられたコンテンツに従業員、顧客、または取引相手の個人データも含まれていた場合、データ受託者は合理的なセキュリティ保護手段を取るというセクション 8(5) の義務を怠る可能性があり、第 8 条 (6) は、取締役会への違反通知義務を発動することができます。 影響を受ける各データ プリンシパルに。
DPDPA へのスケジュールは、セクション 8(5) の失敗に対して 2 億 5000 万ルピー、セクション 8(6) の失敗の場合は 2 億ルピーに及ぶ可能性のあるペナルティを規定しています。 したがって、1 つの不注意なプロンプトは、侵害された企業秘密、サードパーティの資料が貼り付けられた著作権公開の可能性、および 2 つの別々の DPDPA ペナルティ ヘッドの交差点に置かれます。
インドの AI ビルダーのコンプライアンスの 3 つの優先事項
3 つの体制は崩壊しません。 したがって、コンプライアンス作業は 3 つの並行トラックで実行する必要があります。
まず、データセットをマッピングします。 トレーニング データの各ソースについて、著作権で保護された式 (コンテンツがパブリック ドメインであるかライセンス供与されている場合を除く) が含まれているかどうか、個人データ (ほとんどの場合、オープン Web 上) かどうか、およびデータ プリンシパルによってデータが公開されているかどうかを記録します。 セクション 3(c)(ii) の切り分けは、3 番目のカテゴリに対してのみ機能します。 最初の 2 つの義務は、DPDPA ステータスとは無関係に存続します。
第二に、適切な体制への同意を調整します。 第 6 条に基づいて DPDPA の目的で得られた同意は、第 14 条に基づく著作権の複製を認可しない モデル カード、プライバシー通知、および使用条件は、両方の体制を明確に反映する必要があります。
第 3 に、段階的執行カレンダーのビルド。 DPDP フレームワークは、2025 年 11 月 13 日に個別の官報通知を通じて通知されました。 フェーズ I の手続き規定は、公開時に施行されました。 ルール 4 (コンセント マネージャーの登録) は、発行から 1 年間開始されます。
DPDPR の規則 3、5 ~ 16、22 および 23 は、法律の第 3 条から第 17 条に適用され、発行から 18 か月後に発効します。 彼らは、通知、同意、セキュリティ、違反報告、権利、子供のデータ、国境を越えた転送など、実質的な義務を有効にします。 2026 年または 2027 年に発売される製品は、完全な体制に合わせて構築する必要があります。現在行われている保持の選択とモデルの重量の決定は、施行の窓口に残ります。
よくある質問
DPDPA は、セクション 4 に基づいて、デジタル個人データの処理に適用されます。 セクション 3(c)(ii) の除外は、データ プリンシパルが公開したデータまたは法定発行者が公開する義務があるデータのみを対象としています。 個人がオンラインに掲載していないスクレイピングされた個人データは、法律の範囲内に残り、セクション 6 の同意またはセクション 7 の正当な使用が必要です。
セクション 17(2)(b) は、個人データがデータ プリンシパルに固有の決定を下すために使用されず、規定された基準に従う場合にのみ、調査、アーカイブ、または統計目的の処理を免除します。 モデルが、特定可能な個人に関連するアウトプット、推論、プロファイリング、またはターゲティングを生成する場合はどこでも、信頼は困難です。 「データ プリンシパルに固有の決定」の意味は未解決のままです。
1957 年著作権法第 2 条 (d)(vi) は、コンピュータで生成された作品の作者を「作品を作成させる者」と定義しています。 その規定が現代の生成 AI にどのように適用されるかは、インドの高等裁判所ではほとんどテストされていません。 米国の立場が決着した: SCOTUS が裁定を拒否された Thaler v Perlmutter 2026 年 3 月 2 日。
プロンプトがサードパーティ プラットフォームに入ると、機密性が著しく損なわれます。 セクション 8(5) および 8(6) が開始されると (2025 年 11 月 13 日から 18 か月)、貼り付けられたコンテンツに個人データが含まれている場合、雇用主は DPDPA の責任に直面し、最大 2 億 5000 万ルピーの罰金と 200 ルピーの違約金が課せられます。 それぞれクローレ。
2025 年 11 月 13 日付の別の Gazette 通知に基づく段階的施行は、発行時に開始され、フェーズ I では、データ保護委員会の枠組み (運用予定は保留中) と手続き上の規定を有効にしました。 ルール 4 (コンセント マネージャーの登録) は、発行から 1 年後に開始されます。 法律の規則 3、5 から 16、22 および 23 およびセクション 3 から 17 は、公開から 18 か月の効力を有します。
いいえ。DPDPA は個人データを規制しています。 著作権法は表現著作物を規制しています。 データセットは DPDPA に準拠している可能性がありますが、それでもセクション 14 の複製権を侵害します。 著作権の許可は、ライセンスを通じて別途取得する必要があります。セクション 52 フェアディール ヘッドには、現在、AI トレーニングに対するテキストおよびデータ マイニングの明示的な免除は含まれていません。
免責事項
この記事では、インドの知的財産法、2023 年デジタル個人データ保護法、および生成 AI と著作権に関する DPiIT ワーキング ペーパーを含む保留中の規制文書の交差点について説明します。 DPDPA 条項は、DPDPR 2025 に基づく段階的な通知の対象となり、引用された順守日は 2026 年 4 月時点のものであり、インド政府のさらなる通知の対象となります。 DPiIT ワーキング ペーパーは協議文書であり、運用法ではありません。 この記事には、特定の事実に基づく状況に対する法的助言を構成するものは何もありません。 特定の AI 製品コンプライアンスの問題に直面している読者は、資格のある弁護士に相談する必要があります。