

Indiens DPIIT-Ausschuss veröffentlichte im Dezember 2025 sein erstes Arbeitspapier zu KI und Urheberrecht. Die Mehrheit empfiehlt eine obligatorische Pauschallizenz für KI-Trainings, wobei die gesetzlichen Lizenzgebühren über eine neue Verwertungsgesellschaft namens CRCAT abgewickelt werden. Nasscom sprach sich innerhalb des Ausschusses dagegen aus und empfahl TDM mit Opt-out-Option. All dies ist noch nicht in Kraft getreten. Paragraph 52 des Urheberrechtsgesetzes von 1957 gilt weiterhin.
| Kurze Antwort | |
| Was wird vorgeschlagen? | Obligatorische Pauschallizenz für rechtmäßig genutzte Anlagen + gesetzliche Vergütung über eine neue kollektive Körperschaft, CRCAT |
| Status | Arbeitspapier Teil 1, Dezember 2025. Nur ein Vorschlag. Kein Gesetz. |
| Was regelt heute die KI-Ausbildung in Indien? | Urheberrechtsgesetz 1957; Abschnitt 52 angemessene Nutzung; ANI gegen OpenAI (Urteilsverkündung vorbehalten am 27. März 2026) |
| Rechtmäßiger Zugang | Gemäß dem Vorschlag erforderlich. Umgehung von Bezahlschranken oder technischen Schutzmaßnahmen ausgenommen. |
| Vorlaufkosten für Startups | Keine vorgeschlagen. Lizenzgebühren fallen erst an, wenn das KI-Produkt Umsätze generiert. |
| Meinungsverschiedenheiten innerhalb des Ausschusses | Ja. Nasscom empfiehlt TDM mit zweistufigem Opt-out (Anhang E). |
| Demnächst | Das Arbeitspapier Teil 2 wird sich mit KI-Ergebnissen, Urheberschaft und Urheberpersönlichkeitsrechten befassen. |
Die rechtliche Lücke: Warum Abschnitt 52 die kommerzielle KI-Schulung möglicherweise nicht ohne Weiteres abdeckt
Das Urheberrechtsgesetz von 1957 wurde lange vor dem Aufkommen des maschinellen Lernens verfasst. Paragraph 14 gewährt dem Urheberrechtsinhaber das ausschließliche Recht, ein Werk in jeder materiellen Form zu vervielfältigen, einschließlich der Speicherung auf beliebigen Medien mittels elektronischer Mittel. Das Training von KI-Systemen mit urheberrechtlich geschützten Werken kann dieses Speicherrecht beanspruchen, abhängig von der verwendeten Technologie. Ob das Gesetz gemäß Paragraph 52 eine Ausnahme darstellt, hängt davon ab, ob das KI-Training unter die folgenden Kategorien fällt: private oder persönliche Nutzung, einschließlich Forschung, Kritik, Rezension, Berichterstattung über aktuelle Ereignisse oder vorübergehende, zufällige elektronische Speicherung während der Übertragung.
Zur Analyse des Ausschusses Abschnitt 52 – Fairer UmgangWie in Abschnitt 2.3 des Arbeitspapiers dargelegt, fällt kommerzielles KI-Training wahrscheinlich nicht unter die dort aufgeführten Ausnahmen. Indien kennt keine allgemeine Ausnahme für Text- und Data-Mining, die dem britischen CDPA-Abschnitt 29A, dem japanischen Artikel 30(4) oder den Artikeln 3 und 4 der EU-Richtlinie 2019/790 entspricht.
Die Lücke wird derzeit vor Gericht geprüft. ANI Media Pvt Ltd gegen Open AI Inc & AnrIm Fall CS(COMM) 1028/2024 prüft der Oberste Gerichtshof von Delhi, ob die Speicherung urheberrechtlich geschützter Nachrichtendaten für das KI-Training eine Urheberrechtsverletzung darstellt, ob die Nutzung dieser Daten zur Generierung von Nutzerantworten ebenfalls eine Urheberrechtsverletzung ist, ob diese Nutzung unter § 52 als „Fair Use“ fällt und ob indische Gerichte für einen ausländischen Beklagten zuständig sind. Das Urteil wurde am 27. März 2026 vertagt und steht noch aus. Je nach Umfang des Urteils könnte es die erste substanzielle Rechtsprechung Indiens zum Thema KI-Training und Urheberrecht darstellen.
Wie der Ausschuss zu einem Hybridmodell gelangte
Das DPIIT setzte am 28. April 2025 den Ausschuss mit dem Auftrag ein, die rechtlichen Fragen im Zusammenhang mit KI-Systemen zu ermitteln, den bestehenden Urheberrechtsrahmen zu prüfen und Änderungen zu empfehlen. Das erste Arbeitspapier, das im Dezember 2025 veröffentlicht wurde, befasst sich mit urheberrechtlich geschützten Werken als Trainingsdaten. Ein zweites Arbeitspapier soll sich mit den Ergebnissen von KI-Systemen auseinandersetzen.
Sechs regulatorische Ansätze wurden geprüft und in ihrer traditionellen Form als unzureichend befunden. Die freiwillige Direktlizenzierung erwies sich im Umfang des modernen KI-Trainings, für das Milliarden von Datenpunkten benötigt werden, als nicht praktikabel. Eine pauschale Ausnahmeregelung für Technologie- und Datenmanagement (TDM), die von Teilen der Technologiebranche nach Konsultationen unterstützt wurde, wurde als kostenlose Lizenz abgelehnt, die indische Urheber unentschädigt lassen würde. Eine TDM-Ausnahmeregelung mit Opt-out-Option, wie sie in der Europäischen Union gemäß Artikel 4 der DSM-Richtlinie Anwendung findet, wurde als unzureichend befunden, da Indiens überwiegend informeller Kreativsektor nicht über die technischen und verhandlungstechnischen Kapazitäten verfügt, um in großem Umfang einen Opt-out zu ermöglichen. kollektive Lizenzierung durch Urheberrechtsgesellschaften Der Antrag wurde abgelehnt, da die indischen Verwertungsgesellschaften eine unvollständige Mitgliedschaft aufweisen: Große Teile des regionalen und volkstümlichen Sektors sind überhaupt nicht vertreten. Erweiterte kollektive Lizenzen setzten gut organisierte zentrale Gruppen voraus, die in vielen indischen Kategorien fehlten. Traditionelle gesetzliche Lizenzen, wie der Präzedenzfall für Rundfunk gemäß Paragraph 31D zeigt, benötigten in der Vergangenheit Jahre, um die Gebühren festzulegen.
Zu den befragten Interessengruppen gehörten Verwertungsgesellschaften (IPRS, PPL, IRRO, ISAMRA), Verbände der Musikindustrie (IMI, RMPL), Nachrichtensender und Technologieunternehmen. Die Mehrheit der Technologiebranche sprach sich für eine generelle Ausnahmeregelung für TDM aus. Die Medienbranche bevorzugte einhellig eine freiwillige Lizenzierung. Aus diesen unterschiedlichen Meinungen entwickelte das Komitee das Hybridmodell.
Im Hybridmodell: obligatorische Lizenz, CRCAT, Lizenzgebührenfluss
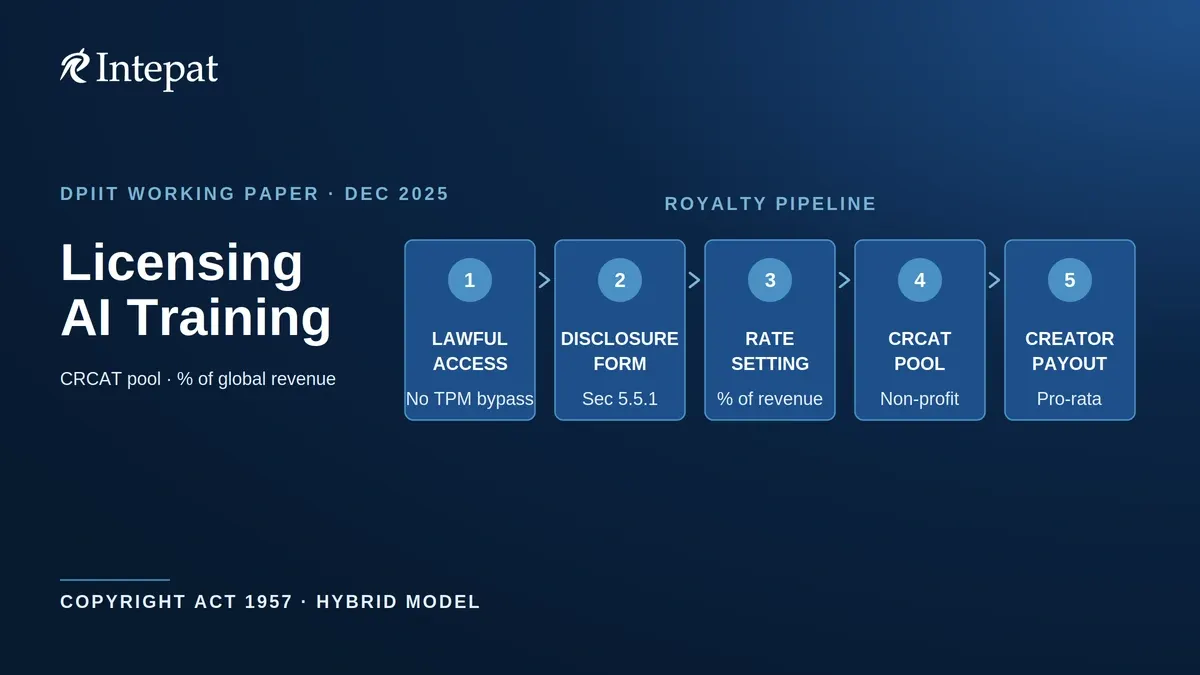
Das Hybridmodell besteht aus sechs Komponenten. Die erste ist eine obligatorische Pauschallizenz, die in das Urheberrechtsgesetz von 1957 aufgenommen werden soll. In der vorgeschlagenen Form würde das Modell die Möglichkeiten von Rechteinhabern, die Nutzung rechtmäßig erworbener Werke für Schulungszwecke zu verweigern, erheblich einschränken. Die zweite Komponente ist eine einzige gemeinnützige Verwertungsgesellschaft, die Copyright Royalties Collective for AI Training (CRCAT), die von der Zentralregierung benannt wird. Die CRCAT-Mitgliedschaft wäre auf eine Organisation pro Werkkategorie beschränkt, die entweder aus nach § 33 des Urheberrechtsgesetzes von 1957 registrierten Verwertungsgesellschaften oder aus gemeinnützigen Verwertungsgesellschaften stammt, die die in den Urheberrechtsbestimmungen festgelegten Zulassungsvoraussetzungen erfüllen.
Die dritte Voraussetzung ist der strikte Nachweis des rechtmäßigen Zugangs. KI-Entwickler können sich nicht auf die Lizenz berufen, um technische Schutzmaßnahmen, Bezahlschranken oder passwortgeschützte Inhalte zu umgehen. Die umfassende Lizenz deckt ausschließlich rechtmäßig erworbene Inhalte ab.
Die vierte Instanz ist ein von der Regierung eingesetzter Gebührenfestsetzungsausschuss, der die Lizenzgebühren als festen Prozentsatz des weltweiten Gesamtumsatzes des KI-Systems festlegt, diese alle drei Jahre überprüft und der gerichtlichen Kontrolle unterliegt. Für Startups ist der Zeitpunkt entscheidend. Während der Trainings- und Vorbereitungsphase fallen keine Lizenzgebühren an; Zahlungen werden erst fällig, wenn das KI-Produkt Umsätze generiert. Die Pay-as-you-earn-Struktur leitet sich von der allgemeineren Logik gesetzlicher Lizenzgebühren ab. Im indischen Urheberrecht ist dies bereits bekannt.
Das fünfte Dokument ist das Formular zur Offenlegung von KI-Trainingsdaten. Gemäß Abschnitt 5.5.1 des Arbeitspapiers muss jeder KI-Entwickler eine „ausreichend detaillierte Zusammenfassung“ bei CRCAT einreichen, die die Datenkategorien gemäß Abschnitt 14 (Text, Bilder, Musik, Tonaufnahmen), die Datenquellen und die Art des Inhalts umfasst. Das Arbeitspapier stellt ausdrücklich klar, dass das Formular nicht dazu dient, Geschäftsgeheimnisse offenzulegen; es orientiert sich an Erwägungsgrund 107 des EU-KI-Gesetzes.
Der sechste Punkt betrifft die Verteilung. CRCAT teilt die eingenommenen Lizenzgebühren anhand der Offenlegungsdaten unter seinen Mitgliedern auf. Diese verteilen die Gebühren wiederum an registrierte Urheber entweder anteilig oder wertbasiert, wobei Zugriffe, Auszeichnungen und Lizenzhistorie berücksichtigt werden. Urheber müssen keiner Verwertungsgesellschaft angehören, um Lizenzgebühren zu beanspruchen, müssen ihre Werke jedoch in einer zentralen Datenbank registrieren. Für Branchen ohne organisierte Vertretung werden die Lizenzgebühren in einem Wohlfahrtsfonds verwaltet. Bildet eine Branche innerhalb von drei Jahren eine Verwertungsgesellschaft (CMO), fließt der Fonds an diese; andernfalls werden die Gelder für gemeinnützige Zwecke eingesetzt.
Die abweichenden Meinungen im Ausschuss: Nasscoms TDM mit Opt-out-Option
Nicht alle Ausschussmitglieder befürworteten das Hybridmodell. Nasscom, vertreten durch Sudipto Banerjee im Ausschuss, legte am 17. August 2025 eine formelle schriftliche Gegendarstellung vor. Die Empfehlung von Nasscom, die wörtlich in Abschnitt 5.1 des Arbeitspapiers wiedergegeben und in Anhang E ausführlich erläutert ist, unterscheidet sich in ihrer Struktur wesentlich.
Nasscom schlägt eine Ausnahme für Text- und Data-Mining vor, die sowohl kommerzielle als auch nichtkommerzielle Zwecke abdeckt. Voraussetzung ist ein rechtmäßiger Zugriff und die Einhaltung der „Treu und Glauben-Sicherheitsvorkehrungen“. Diese Ausnahme gilt ausschließlich für die Trainings- und Eingabeverarbeitungsphase des maschinellen Lernens. Rechteinhaber behalten die Kontrolle durch ein zweistufiges Opt-out-Verfahren: Bei öffentlich online zugänglichen Inhalten erfolgt das Opt-out über maschinenlesbare Signale zum Zeitpunkt der Verfügbarkeit; bei nicht öffentlich zugänglichen Inhalten über Vertrags- oder Lizenzbedingungen.
Der architektonische Unterschied ist grundlegend. Die Mehrheitsmeinung geht von einer obligatorischen Vergütung ohne Ablehnungsmöglichkeit aus. Nasscoms Ansatz hingegen sieht eine standardmäßige Zustimmung mit einer strukturierten Möglichkeit zur Ablehnung vor. Das Arbeitspapier dokumentiert, dass der Rest des Ausschusses das Hybridmodell befürwortete und TDM mit Opt-out aus den in Abschnitt 4.2 dargelegten Gründen ablehnte.
In einer separaten öffentlichen Stellungnahme im Februar 2026 führte Nasscom seine Kritik weiter aus: Das DPIIT hatte noch keine Bestandsaufnahme des bestehenden indischen Lizenzmarktes durchgeführt; die durch Stakeholder-Konsultationen ohne Marktsignale festgelegten Preise bergen das Risiko systemischer Fehlbewertungen; und die vom Hybridmodell vorausgesetzte Infrastruktur zur Eigentumsnachverfolgung ist möglicherweise noch nicht in dem für das KI-Training erforderlichen Umfang ausgereift. Nasscom empfahl ein Verfahren nach britischem Vorbild, bei dem technische Arbeitsgruppen vor der Verabschiedung von Gesetzen evidenzbasierte Berichte erstellen.
Die Stellungnahme von MEITY deckt sich mit den Bedenken der Mehrheit.
Das Ministerium für Elektronik und Informationstechnologie (MEITY) hat seine Unterstützung für das Hybridmodell signalisiert. In seiner Stellungnahme an den DPIIT-Ausschuss (Anlage D zum Arbeitspapier) definiert das MEITY das Urheberrecht als Schutz der „Unantastbarkeit von Arbeit“ und als Belohnung menschlichen kreativen Denkens. Es lehnt die Annahme ab, dass das Gemeinwohlpotenzial von KI ein Kriterium für bedingungslose Immunität vor rechtlichen Anfechtungen sein kann.
MEITY empfiehlt, den Rahmen so zu gestalten, dass „Streitigkeiten und Gerichtsverfahren“ durch klare Regeln auf Ebene der Verwertungsgesellschaften und Verwertungsorganisationen vermieden werden, wobei Beschwerdeverfahren auf beiden Ebenen vorgesehen sind. Damit positioniert sich MEITY auf der Seite der Mehrheit in der Debatte des Ausschusses.
Wo Indiens Vorschlag global einzuordnen ist
Für indische KI-Startups, die grenzüberschreitend tätig sind, steht das Hybridmodell in keinem guten Verhältnis zu den vergleichbaren Modellen.
Die Europäische Union erlaubt gemäß Artikel 3 und 4 der Richtlinie 2019/790 die Nutzung von TDM standardmäßig und verlangt von Rechteinhabern ein aktives Widerspruchsrecht. Japan erlaubt gemäß Artikel 30 Absatz 4 seines Urheberrechtsgesetzes seit der Änderung von 2018 das Training von KI für kommerzielle und nichtkommerzielle Zwecke ohne Widerspruchsrecht, sofern der Zugriff rechtmäßig erfolgt. Das Vereinigte Königreich beschränkt seine Ausnahmeregelung für TDM gemäß Abschnitt 29A des CDPA auf nichtkommerzielle Forschung. Abschnitt 244 des singapurischen Urheberrechtsgesetzes von 2021 deckt die computergestützte Datenanalyse sowohl für kommerzielle als auch für nichtkommerzielle Zwecke ab, ebenfalls vorbehaltlich des rechtmäßigen Zugriffs.
Die Vereinigten Staaten kennen kein TDM-Gesetz. Jeder Fall im Zusammenhang mit KI-Training hängt von der Vier-Faktoren-Analyse zur fairen Nutzung gemäß Abschnitt 107 des US-amerikanischen Urheberrechtsgesetzes ab. während der Fall der New York Times gegen OpenAI weitergeht. Jüngste Entscheidungen von Bezirksgerichten verdeutlichen, wie ungeklärt die Rechtslage weiterhin ist. Bartz gegen Anthropic Und Kadrey gegen Meta-PlattformenDas Bundesbezirksgericht für den nördlichen Bezirk von Kalifornien gab 2025 einem Antrag des KI-Entwicklers auf summarisches Urteil zur fairen Nutzung statt und betonte dabei die transformative Ausbildung. Thomson Reuters gegen Ross IntelligenceDer Bezirk Delaware kam im Februar 2025 zu einem gegenteiligen Schluss und stellte eine Urheberrechtsverletzung fest, als Westlaw-Kopfzeilen zur Entwicklung eines Konkurrenzprodukts verwendet wurden.
Indiens Vorschlag weicht von all diesen ab. Unter den wichtigsten Vergleichsmodellen zeichnet sich Indien dadurch aus, dass es die gesetzliche Vergütung in den Mittelpunkt des KI-Trainingsrahmens stellt. Das nächstliegende indische Äquivalent ist Paragraph 31D des Urheberrechtsgesetzes von 1957, der eine gesetzliche Lizenz für Rundfunk vorsieht. Das Hybridmodell erweitert diese Logik der gesetzlichen Lizenzierung auf einen um Größenordnungen größeren Bereich.
Die Frage der internationalen Vereinbarkeit: Berner 9(2) und TRIPS 13
Ob das Hybridmodell mit Indiens internationalen Urheberrechtsverpflichtungen vereinbar ist, ist eine Frage, die im Arbeitspapier nicht substanziell behandelt wird. Sie verdient eingehende Beachtung.
Artikel 9(2) Berner ÜbereinkunftDas Übereinkommen über internationale Projekte im Bereich der Rechte an geistigem Eigentum (TRIPS-Übereinkommen), dem Indien beigetreten ist, erlaubt Mitgliedstaaten, Ausnahmen vom Vervielfältigungsrecht nur dann gesetzlich festzulegen, wenn drei kumulative Bedingungen erfüllt sind: Die Ausnahme muss in „bestimmten Sonderfällen“ gelten; sie darf „nicht mit der normalen Verwertung des Werkes kollidieren“; und sie darf „die berechtigten Interessen des Urhebers nicht unangemessen beeinträchtigen“. Artikel 13 des TRIPS-Übereinkommens dehnt diese dreistufige Prüfung auf alle ausschließlichen Rechte aus und ist für Indien als WTO-Mitglied bindend.
Das Hybridmodell stellt formal keine Ausnahme gemäß Artikel 9 Absatz 2 der Berner Übereinkunft dar. Es beseitigt nicht den Vergütungsanspruch des Rechteinhabers, sondern wandelt das Genehmigungsrecht in einen Vergütungsanspruch um. Diese Struktur hat bereits Präzedenzfälle in der Berner Übereinkunft. Artikel 11bis Absatz 2 der Berner Übereinkunft erlaubt es den Mitgliedstaaten, Bedingungen für Rundfunkrechte, einschließlich Zwangslizenzen, gesetzlich festzulegen, sofern der Anspruch des Urhebers auf eine angemessene Vergütung gewährleistet ist.
Die entscheidende Frage ist, ob „alle rechtmäßig abgerufenen urheberrechtlich geschützten Werke“ die Bedingung der „bestimmten Sonderfälle“ des dreistufigen Tests erfüllen. Eine allgemeine Ausnahme für KI-Training, die auf jede Werkkategorie und jede Nutzungsart innerhalb der Trainingspipeline angewendet wird, könnte in diesem Punkt Anlass zu kritischer Prüfung geben. Die im Arbeitspapier dargelegte Darstellung des KI-Trainings als eine einzige, klar abgegrenzte Aktivität, die sich von der nachgelagerten Nutzung der Ergebnisse unterscheidet, wird sich in dieser Hinsicht bewähren müssen. Die Vereinbarkeit mit dem Vertrag stellt zwar keine existenzielle Herausforderung für das Modell dar, ist aber ein Risiko, dem die indischen Verfasser explizit begegnen müssen. das umfassendere KI-IP-Rahmenwerk wird in eine Rechnung umgewandelt.
Laufender Rechtsstreit in Indien: ANI gegen OpenAI und was auf dem Spiel steht.
Der bedeutendste indische Prozess bezüglich KI-Training und Urheberrecht findet bereits vor Gericht statt. ANI gegen OpenAI Indien-Fall, formell ANI Media Pvt Ltd gegen Open AI Inc & Anr Vor dem Obersten Gerichtshof von Delhi wurde OpenAI die Verletzung von Urheberrechten durch die Verwendung von Nachrichteninhalten im ChatGPT-Training und in den Ergebnissen vorgeworfen. Richter Amit Bansal formulierte mit Beschluss vom 19. November 2024 vier Fragen: Verletzung der Speicherrechte, Verletzung der Nutzungsrechte für die Ausgabe, Anwendbarkeit der Fair-Use-Regelung gemäß Paragraph 52 und territoriale Zuständigkeit.
Der Anwalt von OpenAI teilte dem Gericht mit, dass der Beklagte auf eine Sperrliste gesetzt worden sei.www.aninews.inIm Oktober 2024 ernannte das Gericht Adarsh Ramanujan, Rechtsanwalt (und Mitglied des DPIIT-Ausschusses), sowie Professor Arul George Scaria von der NLSIU zu Amici Curiae. Sechs weitere Parteien schlossen sich dem Verfahren an: die Digital News Publishers Association, die Indian Music Industry und die Federation of Indian Publishers, die ANI unterstützten; das Broadband India Forum, Flux Labs AI Private Limited und IGAP Project LLP, die OpenAI unterstützten.. Es sind auch damit zusammenhängende Interventionen in angrenzenden Angelegenheiten entstanden.Die
Das Gericht hörte zwischen November 2024 und dem 27. März 2026 32 Anhörungen an, bevor Richter Amit Bansal die Entscheidung über den Eilantrag von ANI vertagte. Das Arbeitspapier erkennt diese Rechtsstreitigkeiten an, geht aber davon aus, dass „das Abwarten eines endgültigen Urteils in solchen anhängigen Verfahren möglicherweise nicht optimal ist“. Ob das Hybridmodell vor dem 27. März 2026 Gesetz wird, bleibt abzuwarten. JAHRE Die Aussprache ist an sich eine politische Frage.
Was KI-Entwickler in Indien jetzt tun sollten
Bis das Hybridmodell vom Parlament verabschiedet und durch geänderte Urheberrechtsbestimmungen sowie die Einrichtung des CRCAT (Consumer Rights Commissioner’s Administrative Tribunal) in die Praxis umgesetzt ist, muss kein KI-Entwickler in Indien bestimmte Maßnahmen ergreifen. Es ist ratsam, sich darauf vorzubereiten.
Für Startups, die heute Trainingsmodelle für indische Inhalte entwickeln, bleibt der operative Rahmen das Urheberrechtsgesetz von 1957, Abschnitt 52 zur fairen Nutzung, und das letztendliche Verhältnis in ANI gegen OpenAI. Zur defensiven Vorgehensweise gehört es, die rechtmäßige Herkunft jedes im Training verwendeten Datensatzes zu dokumentieren, die Umgehung von Bezahlschranken oder technischen Schutzmaßnahmen zu vermeiden und die Dokumentation der Datensatzkategorien, Quellen und Inhaltsart in einer Form zu führen, die in das vorgeschlagene Formular zur Offenlegung von KI-Trainingsdaten konvertiert werden kann.
Für international tätige Unternehmen bietet der indische Vorschlag keine Befreiung von der Einhaltung der Opt-out-Regelungen der EU-Richtlinie 2019/790, der japanischen Zugangsvoraussetzungen gemäß Artikel 30 Absatz 4 oder des US-amerikanischen Fair-Use-Risikos. Wie ein außerhalb Indiens trainiertes, aber für indische Nutzer eingesetztes Modell zu behandeln ist, bleibt im Arbeitspapier offen und ungeklärt.. Angrenzende Verpflichtungen gemäß dem Digital Personal Data Protection Act 2023 Darüber hinaus gilt: Die Einhaltung des Urheberrechts ist nicht gleichzusetzen mit der Einhaltung des Datenschutzes, und ein Datensatz, der unter einem System rechtmäßig ist, kann unter dem anderen System rechtswidrig sein.
Für Unternehmensjuristen endete die öffentliche Konsultation zu Teil 1 am 6. Februar 2026, nachdem das DPIIT die ursprüngliche Frist vom 7. Januar um 30 Tage verlängert hatte. Die nächsten wichtigen Punkte sind das Arbeitspapier Teil 2 zu KI-Ergebnissen, ein möglicher Gesetzesentwurf und die Entscheidung des Obersten Gerichts von Delhi. ANI gegen OpenAIDie
Was Sie bis 2026 im Auge behalten sollten
Drei Zeitpunkte werden darüber entscheiden, ob dieser Vorschlag Gesetz wird. Der erste ist die Entscheidung des Obersten Gerichts von Delhi im Jahr 2016. ANI gegen OpenAIIn dem Fall, in dem das Urteil seit dem 27. März 2026 aussteht, könnte die endgültige Entscheidung zu Abschnitt 52 die Dringlichkeit des Hybridmodells etwas mindern. Zweitens wird das Arbeitspapier Teil 2 zu KI-Ergebnissen voraussichtlich vor der Ausarbeitung eines Gesetzentwurfs veröffentlicht. Drittens ist unklar, wie das DPIIT mit den bis zum 6. Februar 2026 eingegangenen Stellungnahmen aus der Konsultation umgeht. Die abweichende Meinung von Nasscom, die Präferenz der Medienbranche für freiwillige Lizenzen und die Zustimmung des MEITY werden im parlamentarischen Verfahren eine Rolle spielen.. Die breitere Debatte um das Urheberrecht für KI in Indien Die Angelegenheit ist noch lange nicht abgeschlossen, und der endgültige Gesetzentwurf wird nicht der erste Entwurf des Arbeitspapiers sein.
Häufig gestellte Fragen
Nein. Das Hybridmodell ist eine Empfehlung im Arbeitspapier Teil 1 des DPIIT, das im Dezember 2025 veröffentlicht wurde. Die Umsetzung erfordert Änderungen des Urheberrechtsgesetzes von 1957, neue Regeln gemäß den Urheberrechtsbestimmungen von 2013 und die formelle Benennung des CRCAT. Zum Zeitpunkt der Veröffentlichung dieses Textes wurden noch keine dieser Schritte unternommen.
Das indische Recht kennt keine allgemeine Ausnahme für die Nutzung urheberrechtlich geschützter Werke. Schulungen, die die Speicherung und Vervielfältigung urheberrechtlich geschützter Werke beinhalten, fallen unter § 14 des Urheberrechtsgesetzes von 1957. Ob § 52 der Fair-Dealing-Regelung diese schützt, ist ungeklärt und wird nun vom Obersten Gerichtshof von Delhi entschieden. ANI gegen OpenAI. Es ist eine konservative Vorgehensweise, nach Möglichkeit lizenzierte Datensätze zu beschaffen.
Dem Vorschlag zufolge nicht. Der Gebührenfestsetzungsausschuss soll die Lizenzgebühren als Prozentsatz des weltweiten Gesamtumsatzes des KI-Systems festlegen, zahlbar erst, nachdem das System Einnahmen generiert. Startups in der Vorumsatzphase, die sich in der Trainings- und Entwicklungsphase befinden, wären in diesem Zeitraum gemäß dem im Arbeitspapier entworfenen Hybridmodell nicht gebührenpflichtig.
Das Arbeitspapier geht nicht explizit auf grenzüberschreitendes Training und dessen Einsatz ein. Die Lizenzgebühr wird zwar als Prozentsatz des weltweiten Gesamtumsatzes des KI-Systems angegeben, doch bleibt ungeklärt, wie diese anzuwenden ist, wenn das Training außerhalb Indiens stattfindet und der Einsatz indische Nutzer erreicht. Entwickler sollten dies während der Konsultationsphase als offene Frage betrachten.
Abschnitt 5.2 des Arbeitspapiers schlägt vor, dass die Anforderung des rechtmäßigen Zugangs nur prospektiv gilt. Die bisherige Nutzung urheberrechtlich geschützter Werke zu Schulungszwecken unterliegt weiterhin dem bestehenden Rahmen des Urheberrechtsgesetzes von 1957, wie er von indischen Gerichten in Fällen wie beispielsweise … ausgelegt wurde. ANI gegen OpenAI. Die Haftung vor Inkrafttreten des Gesetzes erlischt durch den Vorschlag nicht.
Nein. Gemäß dem vorgeschlagenen Hybridmodell ist der rechtmäßige Zugang Voraussetzung für die Pauschallizenz, nicht etwa die Erlaubnis zur unentgeltlichen Nutzung urheberrechtlich geschützter Werke. Bei Inkrafttreten des Modells würden Lizenzgebühren fällig, sobald das KI-System kommerzialisiert wird. Die Entwicklung und das Training vor der Umsatzgenerierung wären laut Vorschlag kostenlos; die umsatzgenerierende Implementierung hingegen nicht.
Nach geltendem indischem Recht gibt es keine spezifische Opt-out-Regelung für TDM, die dem EU-Modell gemäß Artikel 4 der DSM-Richtlinie entspricht. Laut Nasscoms abweichendem Vorschlag wären maschinenlesbare Opt-outs für öffentlich zugängliche Online-Inhalte relevant. Im Mehrheitsmodell, dem Hybridmodell, ist das Opt-out nicht der zentrale Mechanismus. Entwickler, die Projekte in der EU und in Indien realisieren, sollten beide Modelle berücksichtigen.
Die EU-Richtlinie 2019/790 erlaubt gemäß Artikel 4 standardmäßig das kommerzielle Training von KI, wobei Rechteinhaber über maschinenlesbare Signale widersprechen müssen. Indiens Hybridmodell hebt diesen Widerspruch auf und ersetzt die Ablehnung durch ein gesetzliches Recht auf Vergütung. Die Architekturen unterscheiden sich, und ein in Indien eingesetztes KI-System muss beiden Regelungen entsprechen, wenn es auf beiden Märkten operiert.
Risiko durch KI-Daten?
Wenn Ihr KI-Produkt Datensätze von Drittanbietern, Web-Scraping-Inhalte, lizenzierte Korpora oder nutzergenerierte Inhalte verwendet, sollten Sie die indische Urheberrechtslage vor der Implementierung genauer prüfen. Intepat IP berät KI-Entwickler, Rechteinhaber und Unternehmensjuristen zu Herkunft und Lizenzierung von Trainingsdaten sowie zu Urheberrechtsrisiken in Indien gemäß dem Copyright Act von 1957 und dem sich entwickelnden DPIIT-Rahmenwerk. Kontaktieren Sie uns, um Ihre Situation zu besprechen. Team für UrheberrechtsdiensteDie
Haftungsausschluss. Dieser Artikel gibt den Stand vom 13. Mai 2026 wieder. Das hier beschriebene DPIIT-Hybridmodell ist eine Empfehlung aus Teil 1 eines Arbeitspapiers, das im Dezember 2025 zur Konsultation mit Interessengruppen veröffentlicht wurde. Die Konsultation endete am 6. Februar 2026, und das Modell ist kein geltendes Recht. Das Urheberrechtsgesetz von 1957, einschließlich des Paragraphen 52 zur fairen Nutzung, und ein laufendes Gerichtsverfahren vor dem Obersten Gerichtshof von Delhi bleiben unberührt. ANI gegen OpenAI (Urteilsverkündung vorbehalten am 27. März 2026) bleibt der geltende Rahmen für KI-Training und Urheberrecht in Indien. Dieser Artikel stellt keine Rechtsberatung dar. Entwickler, Content-Ersteller und Rechtsanwälte sollten sich vor der Anwendung des vorgeschlagenen Rahmens von qualifizierten Rechtsberatern beraten lassen.